Quebrando os Limites do Conhecimento
Desde que a Biologia Molecular permitiu uma interpretação codificada da herança genética com base na estrutura dos ácidos nucleicos, o conhecimento biológico tem dado saltos enormes. O simultâneo desenvolvimento advindo da química orgânica e computação têm aberto novos horizontes. Algumas noções básicas desses avanços foram dadas na postagem “Bioinformática, a Biologia da era digital”.
Agora podemos olhar um pouco mais de perto os princípios desses métodos e seus efeitos na pesquisa e desenvolvimento.
OS FUNDAMENTOS MOLECULARES
Modelo chave-fechadura de Emil Fisher (1894) para o funcionamento das enzimas;
Elucidação da estrutura do DNA (Watson e Crick, 1953);
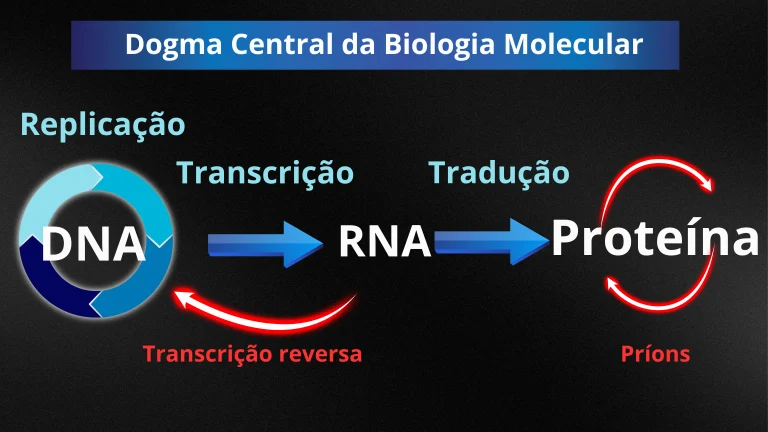
Dogma Central da Biologia Molecular (Francis Crick, 1956);
A elucidação experimental do código genético baseado em trinucleotídeos (trincas ou códons) por Nirenberg e Matthaei (1961), a partir da hipótese de Francis Crick (Crick de novo! Me permitam mencionar que ele, físico de formação, foi um dos maiores gênios da Biologia e que fez parte do grupo de físicos que se encantaram com a Biologia Molecular de sua época – Claro, afinal a Biologia é encantadora!); Nirenberg e Matthaei ganharam o Prêmio Nobel por sua pesquisa (Crick já havia sido laureado juntamente com James Watson pela elucidação da estrutura do DNA em 1953).
Desenvolvimento do sequenciamento genético praticamente ao mesmo tempo pelos grupos de Sanger e Marxan. Isso permitiu análise de ácidos nucleicos cada vez mais extensos; O primeiro genoma sequenciado foi o do vírus bacteriófago ɸX174 (5.286) por Sanger em 1975.
Alinhamento e similaridade de sequências
Uma vez que é possível determinar a ordem em que as bases A, T, C, e G estão em uma molécula de DNA e gerar um arquivo de texto (geralmente tipo FASTA) indicando esta sequência, as possibilidades são gigantescas. Um método básico de análise parte dos alinhamentos de sequências.
Clique na imagem para ampliar.
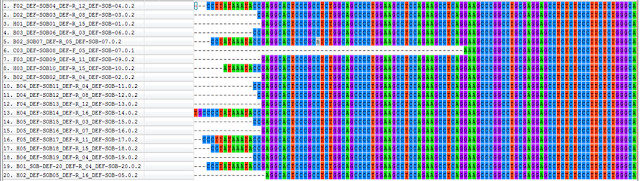
| Exemplo de um alinhamento de sequência de nucleotídeos de DNA. Os números e letras à esquerda são a identificação das sequências (amostras). Os espaços em branco na extremidade esquerda do alinhamento não são mutações e sim ausência de dados. Geralmente as extremidades das sequências são desiguais, uma vez que que as fases iniciais de um sequenciamento são imperfeitas ou porque a extensão das amostras varia, sendo umas maiores que outras. |
Um alinhamento de sequências, grosso modo, é um método que coloca uma sequência (de DNA, por exemplo) sobre a outra a fim de determinar a similaridade entre elas. Um algoritmo analisa a base que ocorre em cada posição da sequência e compara com uma da mesma posição na outra sequência.
POR EXEMPLO: se na posição 1 a base nitrogenada em uma sequência de DNA for T e na outra sequência a base da posição 1 também for T, então tem-se um “casamento” (do inglês, match). Se na segunda posição, uma sequência tem a base C e a outra tem G na mesma posição, obviamente, as sequências diferem nesta posição. É atribuído um sistema de pontuação, como esse mostrado abaixo:
+1 para cada posição de bases correspondentes
-1 para cada posição em que as bases diferem
-2 para ausência de base em uma posição (base deletada, por exemplo), geralmente representada por espaço vazio no alinhamento.
Assim, é possível atribuir um valor numérico que representa a similaridade de uma sequência em relação à outra. Muitos níveis e sistemas de análise podem ser utilizados adicional ou alternativamente a esse. O importante é que, a partir dos alinhamentos e medidas de distância genética, muito conhecimento pode ser produzido, desde filogenias (predição de relações evolutivas) até o efeito de pequenas mutações e polimorfismos que podem afetar nossa saúde.
Outra vantagem é que uma sequência representada por um número (o score, referente à sua pontuação) exige menos capacidade computacional do que a representação da sequência feita letra por letra. Afinal, um número formado por dois ou três algarismos ocupa bem menos memória do que uma sequência de DNA com alguns milhares ou milhões de bases.
UMA CURIOSIDADE:
O genoma humano possui cerca de 3,3 bilhões de pares de bases. Se cada base fosse uma letra de um livro, o livro do nosso DNA teria aproximadamente 1 milhão de páginas. Você pode imaginar o quanto a análise de dados tão volumosos é difícil até para os computadores mais avançados? Além de muitos dados, estamos falando da biologia de um organismo muito complexo!
É claro que converter sequências enormes em um número composto por três algarismos exige muitos cuidados para evitar ambiguidades. Para resolver tais problemas, um algoritmo baseado em uma técnica chamada programação dinâmica compara as sequências duas a duas e em diferentes possibilidades de combinação e cruzamento dos dados. Tais dados são armazenados em uma matriz de programação dinâmica (uma tabela cujo tamanho é igual ao produto do tamanho de uma sequência pelo tamanho da outra).
BLAST – para simplificar toda essa análise complicada que exige uma capacidade computacional gigantesca, foi desenvolvido um sistema de alinhamento simplificado, chamado BLAST (do inglês, Basic Local Alignment Search Tool). O BLAST não garante que será encontrado o alinhamento de pontuação máxima, mas funciona na prática e geralmente encontra os alinhamentos importantes ou mesmo ótimos, mesmo sem a programação dinâmica.
O BLAST encontra regiões de similaridade local entre as sequências. O programa compara sequências de nucleotídeos ou proteínas para bases de dados de sequências e calcula a significância estatística dos matches. O BLAST pode ser usado para inferir relações funcionais e evolutivas entre sequências, bem como ajudar a identificar membros de famílias de genes.
Clustal – é outro exemplo de alinhamento desenvolvido como alternativa à onerosa programação dinâmica. Assim como o BLAST, ele não garante que o melhor alinhamento possível será obtido. Seu funcionamento baseia-se em um alinhamento progressivo em que cada nova sequência é comparada com o alinhamento anterior. O algoritmo realiza após cada alinhamento um procedimento no qual ele seleciona uma sequência e realinha esta com o resto do alinhamento, caso o escore resultante seja melhor que o inicial o novo alinhamento é mantido.
APLICAÇÕES COMPUTACIONAIS NA SAÚDE
Identificando genes e polimorfismos importantes
Um polimorfismo é uma variação na sequência de DNA. Essa variação pode ocorrer desde uma diferença de uma única base (uma troca de A por G, por exemplo) em toda a sequência, ou pela modificação de trechos maiores. Se essa diferença ocorre em menos de 1% da população, é considerada uma mutação (uma mudança “acidental”); se ocorre em uma frequência de 1% ou mais, a variação é considerada um polimorfismo.
A tecnologia de sequenciamento de DNA tem se tornado cada vez mais eficiente e barata. Desse modo, há um número crescente de sequências depositadas em bancos de dados públicos que podem ser baixadas e analisadas com a ajuda de softwares como CAP3, CLUSTALW, MAFFT, TCOFFEE, BLAST e MUSCLE, a maioria deles disponível online ou de download gratuito.
E por que isso é importante? Ora, se são justamente nossas diferenças genéticas (e epigenéticas) a causa próxima da nossa individualidade (seja do ponto de vista fisiológico ou comportamental), significa que estamos avançando muito na compreensão da nossa natureza com grandes implicações na saúde. Lembremos que análises de polimorfismos são feitas para identificar variações em muitos casos: metabolismo diferenciado de medicamentos (que funcionam de modos diferentes em diferentes pessoas), marcadores de risco para câncer e outras doenças crônico-degenerativas, marcadores de bom-prognóstico (sequências que indicam maiores chances de cura em certos tratamentos), polimorfismos/mutações de efeitos prejudiciais, polimorfismos associados ao risco de desenvolvimento de transtornos psicológicos, etc.
A tendência é de que tudo isso se torne cada vez mais acessível. Hoje, testes de DNA para determinação de paternidade ou culpabilidade são cada vez mais rotineiros.
Identificando Alvos Terapêuticos E Seus Ligantes
Isso nos traz ao tema do Zika virus. Vamos utilizá-lo na forma de exemplo de como os métodos computacionais auxiliam na pesquisa para o desenvolvimento de drogas/fármacos.
Assim como as sequências genéticas, moléculas oriundas de síntese química e outros processos correlatos também estão depositadas em bases de dados online. Isso tem provido grande celeridade à busca de moléculas com potencial terapêutico.
Um exemplo recente foi a triagem de 2000 moléculas com o intuito de encontrar alguma com capacidade de inibir a replicação do vírus. Foi possível encontrar uma molécula (nanchangmicina) obtida através do fungo Estreptomyces nanchagensis, com atividade anti-bacteriana e inseticida que se mostrou capaz de inibir a replicação do vírus em testes in vitro com cultura de células.
É a combinação dessas técnicas que permite, de modo tão rápido, determinarmos as relações evolutivas e taxonômicas de um vírus, os genes contidos em seu genoma, as regiões as regiões de uma proteína ou enzima que determinam suas funções biológicas bem como as substâncias que podem interagir com elas. Esse ponto será melhor descrito no tópico seguinte.
Docking: predição de ligantes
As moléculas pequenas geradas por síntese química não possuem informação de um código como o DNA, RNA ou as proteínas. Por outro lado, sua estrutura tridimensional e natureza química podem fornecer muitas informações sobre sua ação em relação a outras moléculas.
O “docking” molecular consiste na predição da estrutura de um ligante dentro das restrições do sítio de ligação de um receptor e no cálculo da força dessa ligação. Em outras palavras, trata-se da seleção de uma molécula capaz de se ligar, por exemplo, ao sítio ativo de uma enzima e calcular a força (estabilidade) dessa ligação.
Como isso é possível?
O princípio é: as propriedades biológicas de uma molécula são uma função de sua estrutura química.
Além da estrutura tridimensional (sua forma), as moléculas possuem grupos químicos (como as funções químicas orgânicas – álcool, carboxila, amina, etc.) com propriedades bem definidas. Além disso, há uma série de descritores moleculares (um descritor é a medida de uma característica da molécula) disponíveis em bases de dados e até mesmo programas capazes de predizer descritores. Para enzimas, proteínas e outras biomoléculas de maior massa, a cristalografia de raios-x e a microscopia eletrônica são bem úteis também, pois fornecem estruturas em alta resolução.
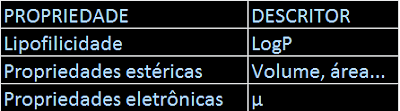
Com uma combinação adequada de métodos, é possível rastrear via Internet as moléculas registradas nas diferentes bases de dados ao redor do mundo, selecionar aquelas com maiores chances de se ligar adequadamente ao alvo terapêutico e simular a interação molecular. Com os dados de genoma, proteoma, transcriptoma e interatoma, as possibilidades de cruzamento de dados tendem a crescer cada vez mais possibilitando abordagens cada vez mais sistêmicas.4
Caso as moléculas selecionadas ainda não contenham as características ideais, você pode desenhar as modificações na nova molécula antes de partir para os testes no laboratório. Portanto, quando estiver fazendo buscas online de moléculas bioativas (na plataforma ZINK por exemplo) para fazer suas compras, lembre-se de que você pode prever as possíveis modificações e redesenhá-la antes dos experimentos. Legal, não?! Boas compras!
Referências
BROWN, Terry A. Clonagem gênica e análise de DNA: uma introdução. Artmed 4ed, 240p, 2003.
KARP, G. Biologia celular e molecular: conceitos e experimentos. 3ª Ed. Barueri: Manole, 2005.
MIR, Luís et al. (Ed.). Genômica. Editora Atheneu, 2004.
MUNJAL, Ashok et al. Advances in developing therapies to combat Zika virus: current knowledge and future perspectives. Frontiers in microbiology, v. 8, p. 1469, 2017.
YURIEV, Elizabeth; RAMSLAND, Paul A. Latest developments in molecular docking: 2010–2011 in review. Journal of Molecular Recognition, v. 26, n. 5, p. 215-239, 2013.